Nonce 比特币挖矿的 AI 自动化
Nonce 比特币挖矿的 AI 自动化,是让 AI 成为矿场运维的判断层:持续读取算力、温度、功耗与矿池数据,识别异常后决定告警、自动恢复或交给工程师。自动化负责稳定执行,AI 负责模式识别与策略选择。
大型比特币矿场正在从「人工看矿机」进入「自动化管理矿机」阶段,而下一步很可能是由 AI 参与判断、预测和执行。所谓比特币挖矿的 AI 自动化,并不是让 AI 代替 ASIC 计算 SHA-256,也不是让大模型去寻找 Nonce,而是让 AI 成为矿场运维系统中的「判断层」:持续读取算力、温度、功耗、在线状态、矿池数据和历史任务,根据大量设备之间的变化识别异常,再决定哪些问题应该告警、哪些可以自动恢复、哪些需要交给现场工程师。
对于拥有数百甚至数千台 ASIC 的矿场来说,这种变化非常重要。传统运维依赖固定阈值、人工巡检和经验判断,一名运维人员可能知道「某台 S21 温度升高后容易掉算力」,但这种经验很难同时应用到几千台设备。自动化规则解决的是「条件明确、动作明确」的问题,而 AI 更适合进一步解决「数据很多、原因复杂、无法只靠一个阈值判断」的问题。Nonce 当前已经把矿机数据采集、异常筛选、批量操作和自动化执行连接起来,这些能力本身就是未来 AI 自动化矿场所需要的数据和执行基础。
比特币挖矿的 AI 自动化究竟是什么?
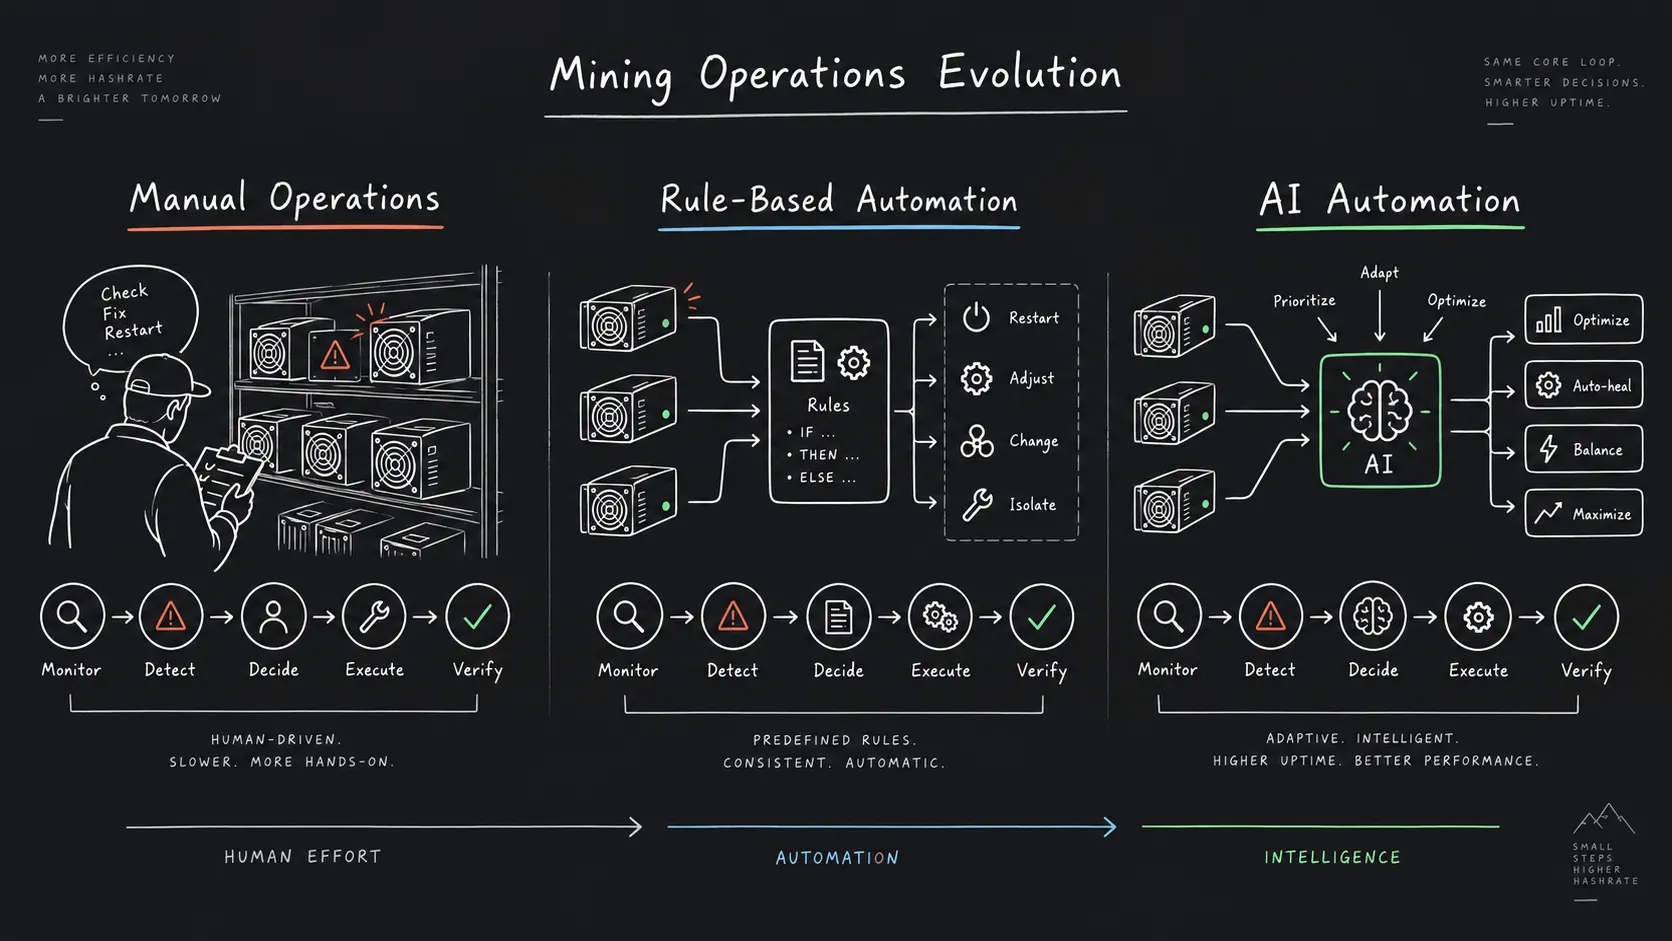
AI 自动化矿场可以简单理解为:把过去由运维人员完成的「观察数据 → 判断问题 → 决定动作 → 执行操作 → 检查结果」,逐渐变成由软件持续完成的闭环。
传统矿机管理系统更多采用固定规则。例如「过去一小时平均算力低于额定算力的 80%,则执行重启」,或者「温度超过设定值,则降低矿机运行强度」。这类规则非常适合处理重复、确定性高的问题,而且本身并不需要 AI。Nonce 的低算力自动重启就是这种自动化方式:系统根据一段时间内的平均算力判断矿机是否持续低于阈值,并在满足条件时向 Agent 下发重启任务,同时设置温度保护、执行频率以及重启次数限制,避免设备陷入无限重启。
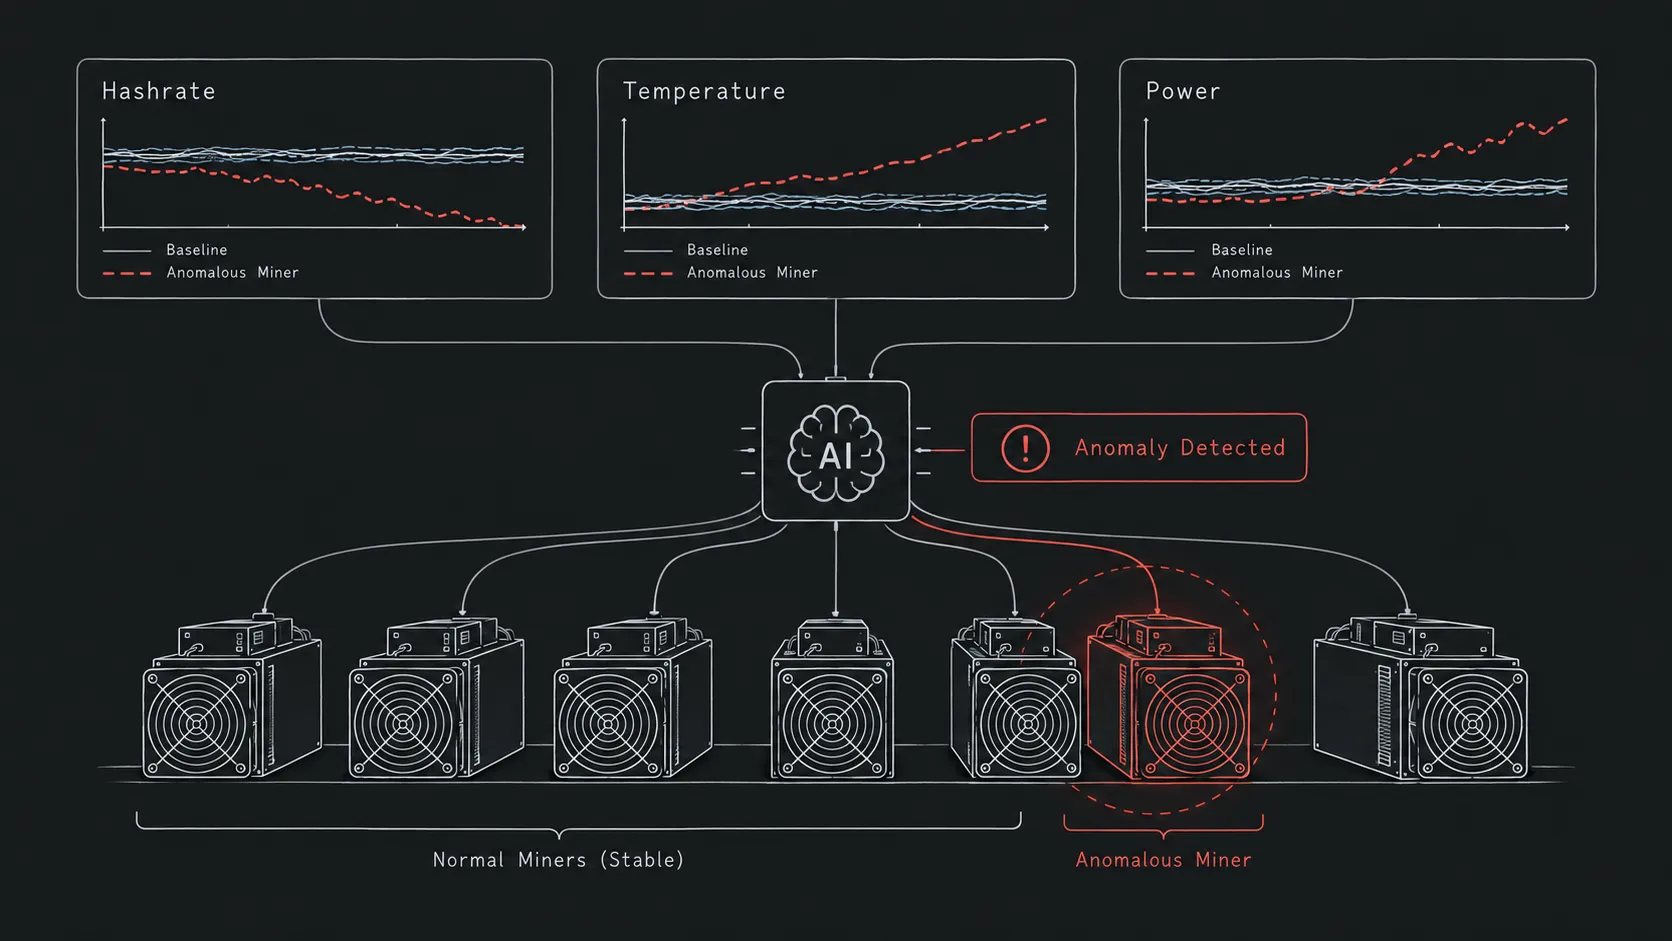
AI 自动化则是在此基础上增加一层更复杂的判断。例如一台矿机的算力仍然高于报警阈值,但过去三天算力波动正在持续放大,同时芯片温度缓慢上升、风扇转速逐渐提高,那么单独观察任何一个指标可能都没有触发传统告警,但多个指标组合后,却可能意味着散热、供电或者算力板正在出现异常。这正是机器学习和异常检测更有价值的场景。
因此,「自动化」和「AI」并不是同一个概念。自动化负责稳定执行,AI 更适合辅助识别模式、预测风险和选择处理策略。
| 管理方式 | 判断方式 | 典型使用场景 | 主要特点 |
|---|---|---|---|
| 人工运维 | 运维人员查看数据并判断 | 复杂硬件故障、现场维修 | 灵活,但难以扩展到大量设备 |
| 规则自动化 | 固定条件触发固定动作 | 低算力重启、高温降频 | 稳定、可控、容易审计 |
| AI 辅助运维 | 从多维历史数据识别异常模式 | 异常诊断、故障预测、告警降噪 | 可以处理更复杂的数据关系 |
| AI 自动化 | AI 判断后调用受限制的自动化动作 | 动态运行策略、自动恢复 | 自动化程度更高,但需要权限和安全边界 |
为什么大型比特币矿场越来越需要 AI 和自动化?
矿场规模扩大以后,真正增加的并不只是矿机数量,而是需要判断的「状态组合」数量。一台 ASIC 可能同时存在 IP、矿池连接、算力板、芯片温度、风扇、供电、固件、矿池算力和运行模式等不同状态。假设矿场拥有 5,000 台矿机,即使每天只有 1% 的设备出现值得关注的异常,也意味着运维团队每天需要处理大约 50 台异常设备,而且这些设备的原因并不一定相同。
更复杂的问题是,很多矿场故障具有群体特征。如果同一个机架的二十台矿机同时离线,逐台判断设备故障通常不是最高效的方式,因为问题可能来自交换机、配电或者局部网络;如果同一批型号在下午高温时段持续出现低算力,问题更可能与环境温度和运行模式有关;如果矿机端显示正常算力,但矿池端有效算力持续下降,则需要进一步检查网络质量、拒绝率或者矿池连接。
这也是为什么矿场管理正在从「单机管理」转向「矿机集群管理」。Tether 在 2026 年开放 Mining OS 时,将其定位为连接矿机、能源和基础设施的统一运行层,并强调通过统一数据和自动化管理大规模挖矿设施。Bitdeer 在 2026 年年度披露中也提到,其内部软件已经将实时监控、矿机健康、环境指标、远程自动化、电力管理和预测性维护流程连接起来。
这说明大型矿场的软件竞争正在从「有没有设备列表」转向「能不能把数据转换成动作」。
Nonce 的多条件筛选正是在解决这一层问题。系统可以按照运行状态、温度、算力、型号、机架等条件组合筛选设备,把几千台矿机缩小成真正需要处理的异常集合。AI 进一步加入后,这套逻辑可以从「用户主动设置筛选条件」继续向「系统主动发现异常组合」发展。
AI 如何判断一台矿机正在变得异常?
AI 在矿场中最有价值的地方,不一定是发现已经彻底离线的矿机,因为「在线 / 离线」本身非常容易判断。更值得解决的问题,是设备还在工作,但已经开始偏离正常状态。
例如某台 ASIC 最近七天的平均算力分别为额定算力的 99%、98%、97%、95%、93%、91%、89%。如果矿场设置的低算力阈值是 80%,传统规则暂时不会采取任何措施,但趋势已经非常明显。再把温度、风扇转速、算力板状态以及同型号设备表现加入模型,系统就有机会判断这是正常波动,还是设备性能正在持续恶化。
这种方式可以进一步形成「同类设备基准」。例如一个矿场同时运行 500 台相同型号的 S21,与其简单规定所有设备超过某个温度都算异常,不如比较相同区域、相同型号和相似运行时间的矿机。如果绝大多数设备在相同环境下保持稳定,而其中几台温度、算力波动或者能效开始明显偏离集群,就值得优先检查。
预测性维护已经成为更广泛工业设备管理领域的重要方向,其基本思路并不是等待设备越过一个固定报警阈值,而是结合设备之间的横向比较和历史变化发现正在形成的异常。对比特币矿场而言,这种方式尤其适合 ASIC 数量多、型号相对标准化、长期持续产生运行数据的环境。
从「发现低算力」到「自动恢复」,Nonce 如何形成自动化闭环?
真正有价值的矿场自动化不能停留在「发现问题」。如果系统告诉值班人员有 40 台矿机低算力,但工作人员仍然需要逐台进入矿机后台查找 IP、查看日志、点击重启,那么监控系统只是缩短了发现时间,并没有完全解决处理效率的问题。
Nonce 的管理逻辑是将「发现异常」与「执行动作」连接起来。矿机筛选可以首先找出离线、零算力、低算力或高温设备,再通过批量操作处理同一类设备。对于频繁出现且具备明确处理方式的问题,则可以继续交给自动化规则。
以低算力为例,Nonce 的自动重启不是看到瞬时算力下降就马上重启,而是观察一段时间内的平均算力,并允许不同矿机型号使用不同阈值,同时加入温度保护、频率限制和重启次数限制。这样可以降低短期算力波动造成误触发的概率,也避免故障矿机被系统反复重启。
温度管理同样可以自动化。Nonce 的运行模式自动化可以根据一段时间内的平均温度调整矿机运行模式。例如环境温度持续升高时降低运行强度,环境恢复后再重新提高运行模式,并通过执行间隔限制避免设备频繁切换。
这实际上已经构成一个基础闭环,即「持续采集运行数据 → 判断矿机状态 → 满足条件 → 自动执行动作 → 继续采集数据 → 判断是否恢复」。
AI 可以插入其中的「判断」环节,使原来依赖固定阈值的条件逐渐变得更加动态,但执行层仍然需要保持明确、可控和可追踪。
AI 自动化不应该等于「让 AI 随便控制矿机」
矿场引入 AI 时,一个非常重要的原则是:判断能力可以变得智能,但执行权限必须存在边界。
如果一个模型错误判断温度异常并一次性关闭几千台矿机,造成的损失可能远高于人工处理慢几分钟。因此成熟的 AI 矿场系统不应该简单设计成「AI 得出结论后直接控制所有设备」,而应该根据风险等级区分不同动作。
低风险并且容易恢复的任务,例如重新采集数据、读取日志、生成异常设备列表,可以允许系统直接执行;具有明确规则和保护机制的动作,例如单台低算力矿机重启,可以由自动化完成;涉及大量设备切换运行模式、批量修改矿池、固件升级或者大规模停机的操作,则应该设置更严格的权限、设备数量限制或者人工确认。
Braiins 在其 2026 年自动化功能中同样采用了「条件 + 动作 + 通知」的方式,让矿场按照设备状态触发矿池配置等动作。这种结构说明,智能矿场的核心并不是追求完全无人化,而是把机器适合完成的重复判断与执行逐渐交给系统,同时为高风险动作保留明确控制边界。
未来即使引入更加成熟的 AI Agent,这一点也不会改变。AI 可以告诉运维团队:「这个机架的异常更可能来自网络而不是 18 台矿机同时损坏」,也可以建议下一步检查交换机,但真正执行影响整个矿场的操作时,仍然需要权限系统、操作记录和安全策略。
AI 还能把自动化从设备健康扩展到挖矿利润
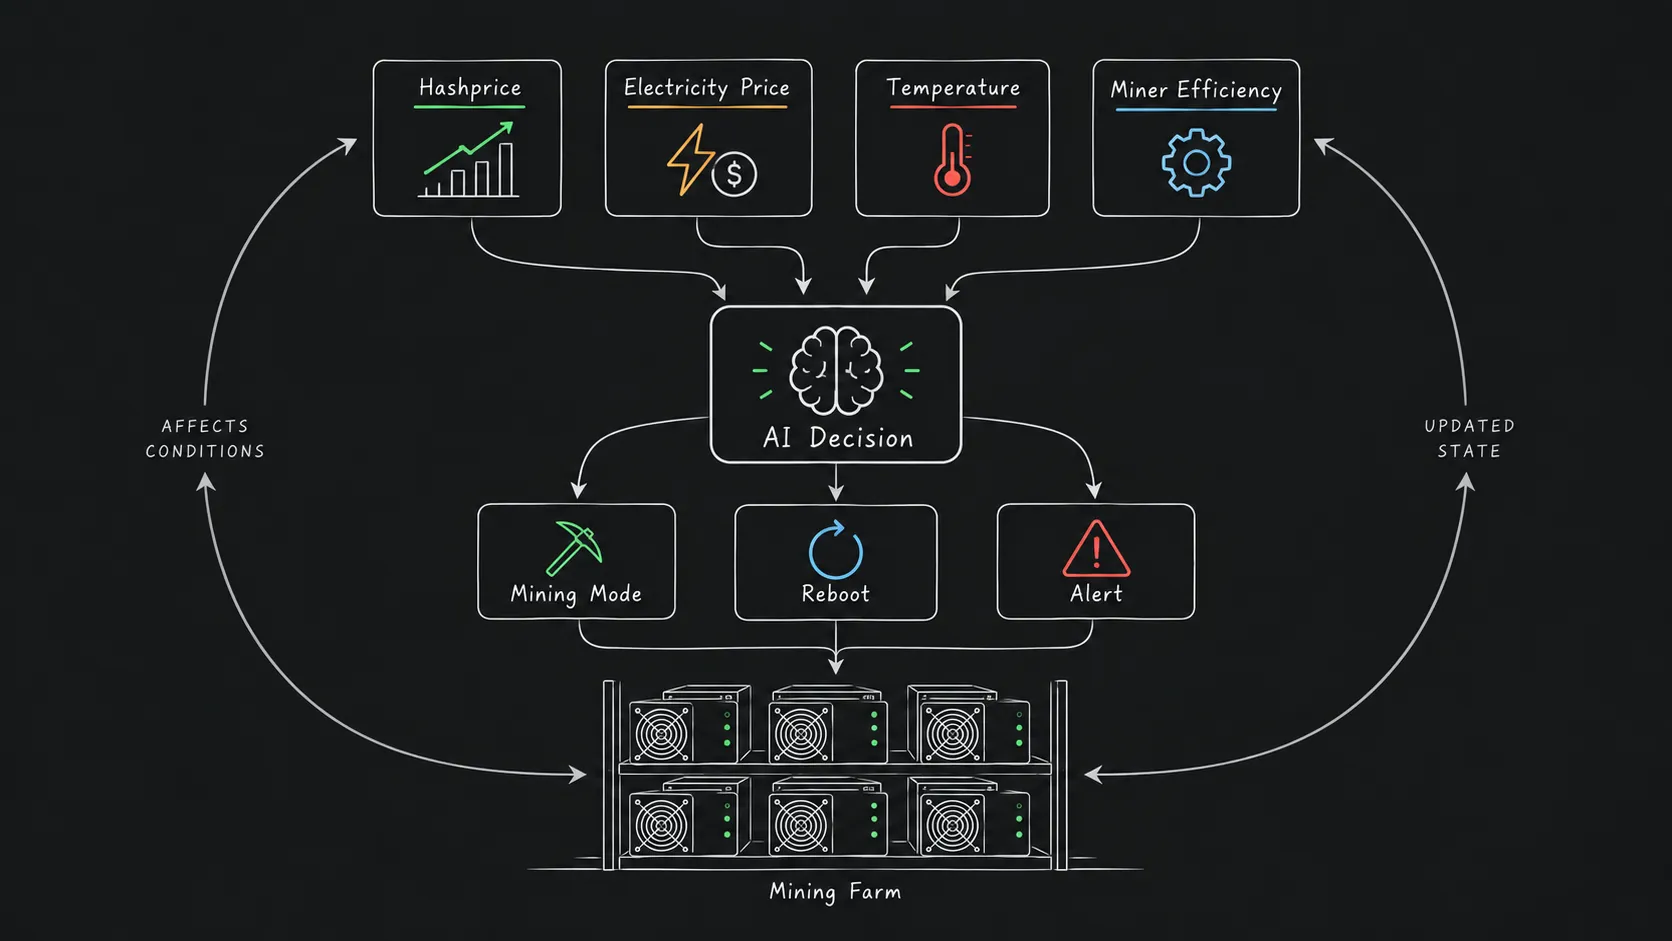
比特币矿场与一般数据中心最大的区别之一,是它的收入和电力成本都具有高度动态性。同一台矿机今天值得满负荷运行,并不意味着任何时间都应该保持同样的运行策略。BTC 价格、全网难度、交易手续费、Hashprice、电价、需求响应补贴和设备能效都会共同影响矿机的边际利润。
因此 AI 自动化的另一个重要方向,是从「保证设备在线」逐渐扩展到「让设备在更合适的状态下运行」。
Luxor 在 2026 年推出的 Commander 已经展示了这种方向,其自动化系统可以结合实时算力市场、电力市场、矿机类型和能源成本调整矿机功率策略,并以固定周期重新计算运行条件。这与传统的「每天固定时间关机」完全不同:系统需要持续判断当前产生 1 TH/s 算力所获得的收入是否高于对应的能源和运营成本。
未来一个更加完整的 AI 矿场可能同时观察 BTC 收益、电价、温度、矿机效率和设备健康。例如,当电价进入高峰且 Hashprice 较低时,系统优先降低低效率矿机功率;当环境温度降低且电价进入低谷时,再让效率较高的设备提高运行强度;如果某台矿机虽然理论利润为正,但设备健康评分持续恶化,则不一定继续超频,而是降低负载并安排维护。
因此 AI 自动化最终优化的可能不是「算力最大化」,而是「风险调整后的利润最大化」。
AI Agent 可能怎样改变矿场值班方式?
今天的矿场值班人员通常需要在多个页面之间切换:查看矿机列表、判断异常数量、阅读告警、查看矿机日志、确认矿池状态,然后决定是否重启或者安排现场维修。当设备数量达到几千甚至几万台以后,真正消耗时间的往往不是点击「重启」,而是从大量信息中判断「现在最应该处理什么」。
AI Agent 可以把这部分信息处理工作进一步压缩。
未来运维人员可能不再需要从几千台设备中逐条浏览数据,而是直接询问:「过去两小时哪个区域的有效算力下降最多?」系统读取矿场数据后返回具体机架,并进一步解释其中大部分设备表现为低算力而非离线;运维人员继续询问:「这些设备有什么共同异常?」系统再结合温度、型号、运行模式和历史任务判断最可能原因。
如果判断属于已经定义好的低风险故障,AI Agent 甚至可以调用现有自动化能力处理,然后继续观察设备是否恢复。如果连续两次操作仍然无法恢复,再自动升级成人工工单。
这里真正发生变化的不是聊天界面,而是矿场的人机分工,过去是「人找数据,人判断,人执行」。规则自动化阶段变成「系统找数据,人判断,系统执行」。
AI 自动化进一步变成「系统找数据,AI 辅助判断,自动化执行,人处理例外」。这也是 AI 最适合大型矿场的地方:它不是取代现场工程师维修坏掉的算力板,而是减少工程师每天花在筛选正常设备、查看重复告警和执行重复操作上的时间。
Nonce 的 AI 自动化,核心应该是从「管理矿机」走向「管理异常」
目前 Nonce 已经建立了 AI 自动化所需要的几个基础层。矿场总览持续汇总算力、效率、矿机状态等运行数据;多条件筛选负责从大量设备中定位异常矿机;自动重启和运行模式自动化负责把部分重复操作交给系统执行;任务记录则可以继续用于检查执行结果。
这几层连接起来后,矿场管理的核心问题已经从「怎么远程控制矿机」发生变化。
真正值得继续优化的是:系统能不能更早发现异常?能不能判断哪些异常实际上来自同一个根因?能不能减少重复告警?能不能根据矿机历史表现判断设备可能出现的问题?能不能在电价、温度和挖矿收益变化时自动选择更合理的运行策略?这些问题,才是 AI 与比特币矿场管理真正结合的方向。
因此,「Nonce 比特币挖矿的 AI 自动化」并不是给现有矿机管理功能简单增加一个 AI 标签,而是一条从数据采集、异常识别、规则自动化逐渐走向智能决策的演进路径。
矿场规模越大,这条路径的价值越明显。拥有十台 ASIC 时,运营者可以记住每台矿机的问题;拥有一万台 ASIC 时,没有任何人能够持续记住每台设备过去几个月的温度、算力、重启次数和故障规律,但软件可以。
未来矿场真正需要管理的,也不再是每一台正常工作的矿机,而是不断变化的异常、风险和利润机会。AI 负责帮助系统理解这些变化,自动化负责把判断转换成可靠动作,而矿场运维人员则把精力集中在真正需要经验、维修和决策的问题上。
这可能才是 AI 自动化对比特币挖矿最大的意义:不是让矿场变成「无人矿场」,而是让大量原本依赖人工发现、判断和重复执行的工作,逐渐变成一个持续运行、可以验证、可以控制的自动化运营闭环。